AI利用は著作権の問題にならないの?-AI生成物を使う場合に知っておきたい著作権のリスク-
江川 祐一郎
知財で先読み!「ゆめ知財」
このブログでは、「生成AIと著作権」をテーマとして、AI学習、AI生成物、国内外のルール、著作権に関連する権利、クリエイターの権利を防衛する策などを、2026年上半期の動きとして、シリーズで取り上げてきました。
一方、生成AIをめぐる状況は、その後も動き続けています。そのひとつが、2026年8月25日に政府が策定した、以下のような長い名前の文書です。以前の記事では案の段階でしたが、正式版が決まっています。
この内容を見ていると、生成AIと著作権をめぐる議論が、「AIが著作物を学習することの是非」から、「AI学習の実態をどこまで説明すべきか」という、実務面へ展開していることが分かります。
今回は、このプリンシプル・コードを中心に、その後の海外動向もあわせて見ていきたいと思います。
プリンシプル・コードは、AI事業者が行うべき透明性の確保や、知的財産権の保護に向けた措置について、原則を示したものです。
ただし、法律のような強制力を持つルールではなく、守ることが望ましいとされる指針、いわゆる「ソフト・ロー」です。
これは、いわゆる「コンプライ・オア・エクスプレイン」、つまり「原則を実施する。実施しない場合には、その理由を説明する。」という仕組みです。簡単に言えば「AI事業者に説明責任を果たしてもらう」という考え方です。
これにより、権利者や利用者との対話を促していく考えを示しています。プリンシプル・コードには、以下のとおり、大きく3つの原則があります。
すべての学習データを公開すべき、といった仕組みではなく、営業秘密などにも配慮しつつも、できるだけ対外的に説明できる状態を作ろうという制度設計です。
なお、政府は、このプリンシプル・コードを受け入れる事業者から届出を受ける仕組みを設けています。内閣府知的財産戦略推進事務局への届出は、2026年10月26日から開始される予定で、届出様式も公表されています。
これまで生成AIと著作権というと、「著作物を無断でAIに学習させてもよいのか?」という議論が中心になりがちでした。
しかし、今回のプリンシプル・コードを見ると、それ以外の論点に焦点が当てられています。例えば以下のとおりです。
つまり、「学習が許されるか否か」という適法性だけではなく、「何をやったか説明できるか」という透明性やガバナンスも問われるようになってきた、と言えるかと思います。
一方、米国の状況を見ると、法律上の争いが激しくなる中、日本と似たような動きも見られます。
2026年8月28日には、Sony Music PublishingやWarner Chappell Musicなどの音楽出版社35社が、生成AI「Claude」を運営するAnthropicなどを米国で提訴しました。
原告側は、歌詞や楽譜などを無断でClaudeの学習等に利用されたと主張、Anthropic側は争う姿勢を示しています。
まだ原告が主張を提示した段階ですが、ここでは、AI学習の合法性に加えて、学習データの取得経路も問題として挙げられています。
一方、「ChatGPT」を運営するOpenAIとNew York Times等との著作権訴訟では、米国政府がOpenAIを支持する意見書を裁判所へ提出しています。
米政府は、AI学習についてフェアユースに当たるとし、AIの発展を、科学技術・国家安全保障・経済競争力などと結び付けて論じています。
これは米政府の意見であって、裁判所がそれを認めたという話ではありません。しかし、この米政府の意見は、日本政府の考え方とも通じるところがあると言えます。
その後、この訴訟では、OpenAI・Microsoft側とNew York Times・著作者側の双方が、AI学習がフェアユースに当たるかを中心に略式判決を求めており、裁判所の判断が注目される段階に進んでいます。
こうした動きからは、生成AIと著作権の問題が、「AI企業 vs クリエイター」という単純な構図ではなく、権利者保護、AI産業育成、国家競争力について、どのようにバランスを取るかという政策問題でもある、ということが見えて来るかと思います。
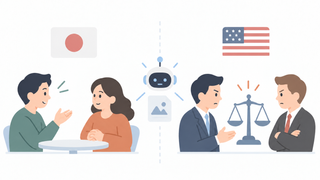
上述したとおり、日本と米国では、AIと著作権の取扱いについて、共通する部分もあります。
しかし、日本と米国では、法制度や文化が相当に異なります。そうした観点からすると、このふたつの国の動きには、興味深い違いが見えます。
米国では、「AI学習はフェアユースか否か」「データの取得方法に問題があるか否か」といった線引きが、複数の訴訟で争われています。さらに今回のOpenAIとNew York Times等との訴訟では、米政府も意見書を提出し、AI学習とフェアユースについて見解を示しています。
一方、少なくとも今回のプリンシプル・コードでは、政府が一定の方向性を示しつつ、直ちに罰則を伴う強制的な規制を導入するのではなく、AI事業者に対して、自主的な対応と説明を促す仕組みが採用されています。
今回取り上げた動きだけを比べれば、いわば、日本は「対話」、米国は「訴訟」といった対照が見えます。
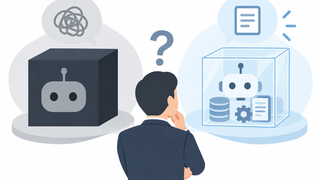
プリンシプル・コードの主な対象は、AIサービスの開発者や提供者です。
しかし、そうしたAIサービスを利用する側である個人や中小企業にも、無関係とは言えない側面があります。
個人や中小企業がAIサービスを選ぶ場合、普通ならば「どちらのAIの性能が高いか」「料金はいくらか」といった点が、主な比較の対象かと思われます。
しかし今後は、「そのAI事業者が、学習データや知財保護について、どこまで説明できているか?」といった点も、ひとつの選択基準になってくる可能性があります。
特に、生成AIを重要な業務に利用したり、生成AIで作成したコンテンツを提供するビジネスを行っている企業などにとっては、自身がAIと著作権の問題に巻き込まれたり、何らかの違反をしてしまう可能性があり得ます。
そのような問題が起きたときに、AI事業者からどのくらいの情報やサポートを受けられるかという点が、かなり重要なポイントになってくると思われます。
AI事業者にとっても、そうしたサポートを提供する能力や体制を充実させることが、激しい競争を生き残るための重要なポイントになってくるのかも知れません。
AIと著作権をめぐる問題は、今後も尽きないと思われます。
米国ではまだまだ訴訟が続いており、日本でもプリンシプル・コードがどこまで浸透するかは未知数です。
こうした状況から、AIと著作権の問題に関しては、ルールづくりの様子を横目で見ながら、実際の利用を進めていかねばならない、という状態が続くと言えます。
一方、プリンシプル・コードについては、「AI学習の在り方を説明できること」という、少なくとも企業におけるガバナンスとしては、当たり前とも言える方針が示されました。
生成AIのように新たな技術が急速に浸透していく状況では、法制度の完成を待つのではなく、そのときの状況に応じて、自らの方針は自分で決めることが、現実的な一歩と言えます。
このブログでは、AIと知財の関係については、今後もウォッチしながら、折を見て記事にしていきたいと思います。
生成AIと著作権・知的財産について体系的に知りたい方へ
AI学習、AI生成物、肖像権・商標権、ルールづくり、コンテンツ保護、透明性など、生成AIと知的財産に関する記事をテーマ別に整理しています。
生成AIと著作権・知的財産|AI学習・生成物・ルール・権利保護の実践ガイド