その技術分野のカギとなる技術は何か?~相関分析による関連技術の発見方法
江川 祐一郎
知財で先読み!「ゆめ知財」
大量の文字や文書データについて、「どんな言葉が多く使われているのか」「どんな話題が含まれているのか」を、ザックリと知りたいことがあるかと思います。
そのようなときに役立つのが「テキストマイニング」です。
以前は専用ソフトを使わなければ難しい分析も多かったのですが、現在ではブラウザで利用できる無料サービスが増えています。
この記事では、無料または無料枠のあるWebサービスを比較しながら、テキストマイニングをどのように使い分ければよいかについて紹介していきます。
テキストマイニングとは、大量の文章を単語などの単位に分け、出現頻度や単語同士の関係などを分析して、その中から有用な情報を見つける方法です。
マイニング(Mining)とは本来、鉱山から鉱物を掘り出すことを意味します。それになぞらえて、大量のテキストの中から情報を掘り出すことから「テキストマイニング」と呼ばれています。
よく知られているのが「ワードクラウド」で、出現頻度の高い単語ほど大きく表示するようなビジュアル解析を提供します。
その他にも、テキストマイニングでは、以下のような分析も可能です。
特許データにも、発明の名称、要約、請求の範囲、発明の詳細な説明など、大量の文字情報が含まれています。これに対してテキストマイニングを使えば、件数や特許分類だけでは見えにくい技術的な特徴について、概要を把握することが可能となります。
特許データを使って、とりあえずテキストマイニングを試してみたい場合には、「ゆめ知財」が提供するWebアプリ「VisiP☆Tex」が、ひとつのお勧めです。
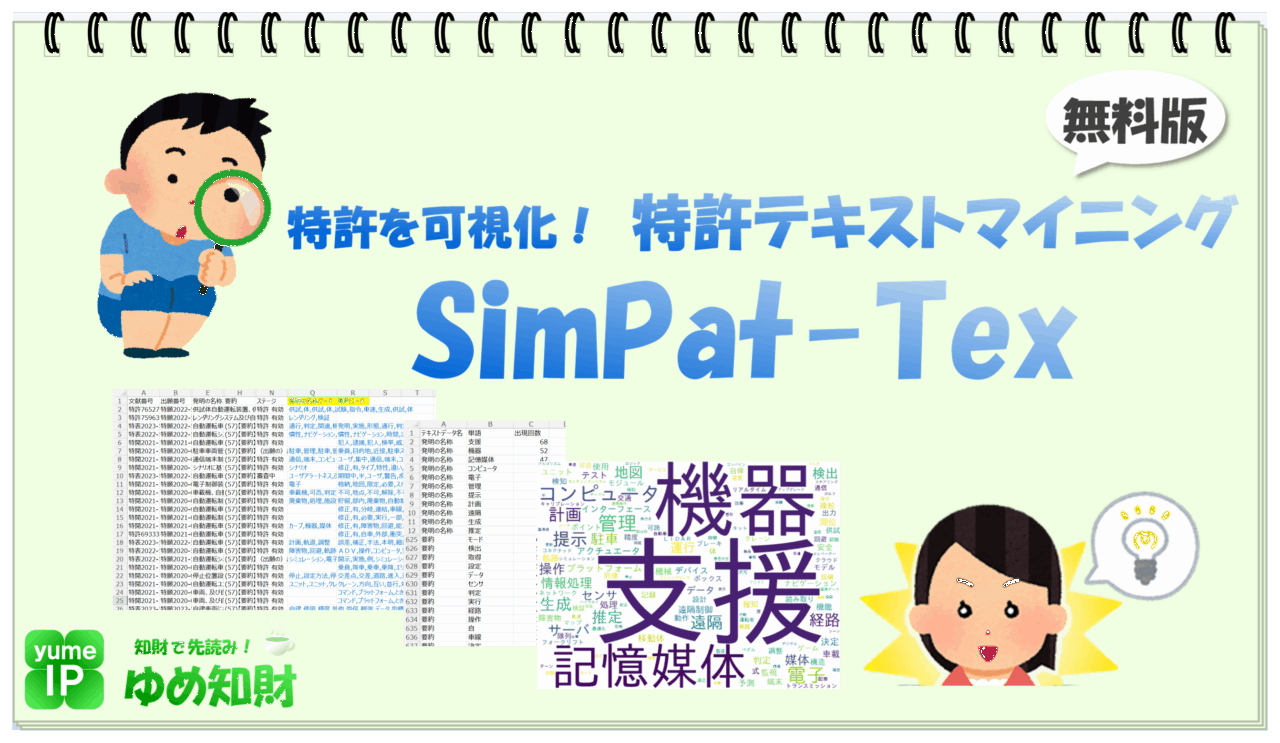
J-PlatPat、Google Patents、PATENTSCOPE、The Lensなどからダウンロードした日本語の特許データを登録すると、「発明の名称」や「要約」から単語を抽出できます。2026年9月現在、アップロード1回あたりの上限は約10MBで、「発明の名称」と「要約」の合計400,000文字まで処理できます。
結果はワードクラウドとして見ることができ、現在の画面では共起ネットワークも表示できます。また、抽出したキーワードを元の特許データに追記したCSVや、頻度順に整理したワードリストもダウンロードできます。
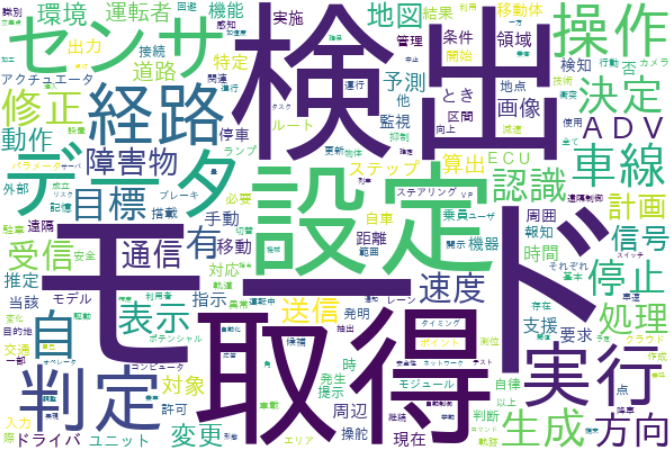
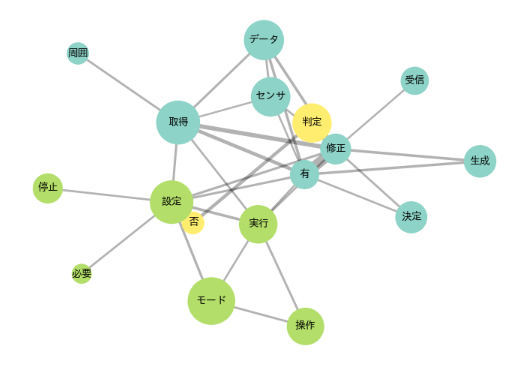
また、以下のような辞書機能も利用することができます。
ただし、「VisiP☆Tex」はあらゆるテキスト分析を行う万能ツールではありません。一般的な文章の感情分析や、係り受け解析、N-gram、TF-IDF、クラスタリングなど、さらに別の分析を行いたい場合には、他のサービスを使った方が適しています。
2026年9月現在、ブラウザー上で日本語を分析できるサービスはいくつかあります。以下に、代表的なサービスを挙げます。
| サービス | 主な特徴 | 無料利用の目安 | 向いている用途 |
|---|---|---|---|
| VisiP☆Tex | 特許データ、ワードクラウド、共起、辞書、キーワードデータ出力 | アップロード約10MB、発明の名称+要約は合計400,000文字まで | 特許データを手軽に俯瞰 |
| ユーザーローカル社 AIテキストマイニング | 頻度、共起、2次元マップ、係り受け、クラスタリングなど多機能 | 通常入力は最大10,000文字・10MB | 一般文章を含め幅広く分析 |
| KeiKouTech社 KOTOPY | 頻度、N-gram、周辺語、TF-IDF、比較分析など | 無料プランは保存1MB、登録データ3件、プロジェクト3件 | 分析方法を一歩広げたい場合 |
| CODE:LIFE Tools ワードクラウド生成 | 日本語のワードクラウド生成、頻度一覧の出力、ブラウザー内で処理 | 最大50万文字、ファイルは2MBまで | 手軽なワードクラウド作成、外部送信を避けたい場合 |
各サービスの機能や利用条件は変更される可能性があるため、実際に利用する際には公式サイトの最新情報を確認してください。
ユーザーローカルが提供する「AIテキストマイニング」は、ワードクラウド、単語出現頻度、共起、2次元マップ、係り受け解析、階層的クラスタリングなど、多くの分析機能をWebサービスとして提供しています。
通常の入力画面では最大10,000文字、ファイルサイズ10MBまでで、テキスト、CSV、Word、Excel、PowerPoint、PDFなどに対応しています。無料のユーザー登録によって利用できる機能も広がります。
「VisiP☆Tex」が特許データを前提としているのに対し、「AIテキストマイニング」は一般の文章も含め、さまざまな分析を一つのサービスで試したい場合には有力な選択肢です。
なお、入力した情報は、自分で結果URLを公開しない限り勝手に公開されず、生成AIなどのAI学習にも利用しないと案内されています。
もう少し分析方法を広げてみたい場合には、KeiKouTechが提供する「KOTOPY」という選択肢もあります。
無料プランでも、頻度分析に加えて、N-gram、N-gram周辺語、TF-IDF、比較分析、全文検索などを利用できます。
一方、無料プランの保存容量は1MB、登録データ数は3件、プロジェクト数は3件なので、大量データを無料で処理する用途というより、さまざまな分析手法を試してみる用途に向いています。
有料プランまで広げれば、主成分分析、トピックモデル、感情分析なども利用できます。
CODE:LIFE Toolsは、テキストマイニング専用のサービスではなく、文字数カウント、テキスト変換、CSV処理、PDF処理、画像加工など、多数のWebツールが公開されており、その中の一つとして「ワードクラウド生成」が提供されています。
ワードクラウド生成では、日本語の文章を形態素解析し、出現頻度の高い単語を大きく表示して視覚化できます。最大50万文字まで入力でき、テキストファイル、CSV、Markdownファイルは2MBまで読み込めます。
また、標準的な不要語の除外に加えて、自分で除外語を指定したり、最小出現回数や最大表示語数を設定したりできます。結果はPNG・SVGの画像のほか、単語の頻度一覧をCSVで保存できます。
特徴的なのは、入力した文章やファイルを外部サーバーへ送信せず、ブラウザー内で処理することです。そのため、外部サービスへのデータ送信を避けながら、まずワードクラウドや頻出語を確認したい場合には使いやすい選択肢です。
一方、今回確認した範囲では、共起分析、係り受け解析、クラスタリング、TF-IDFなどを行うテキストマイニングサービスではありません。そのため、高度な分析を行うというより、文章全体にどのような言葉が多いかを手軽に俯瞰する用途に向いています。
テキストマイニングした結果をワードクラウドなどによって分析することで、対象となる「母集団」が目的に合っているか、大まかに判別することが容易になります。
もし、目的とするワードが表示されなかったり、意図しないようなワードが大きく表示されている場合は、母集団が適切でない可能性があるため、再検索が必要かどうかを判断するためのひとつの目安になります。
また、「人口知能」や「AI」など、似たような意味のワードが複数表示されたり、「方法」や「装置」など分析上ではあまり意味のないワードが多数表示される場合は、それらを辞書などで統合したり除外する判断も必要となります。
そのように幾つかの手を入れて加工していくことで、対象とする母集団がどのような意味を持つデータなのかを、徐々に明確にしていくことができます。
ただし、テキストマイニングの目的は、きれいなワードクラウドを作ることではありません。その結果から気になるワードやワード同士の関係性を見出し、そこから技術動向や競争環境の分析などにつなげていくことが重要です。
テキストマイニングは、そのような情報分析への入口として、たいへん便利な道具といえます。
特許検索、データ取得、特許分類、Excelによる特許マップ、テキストマイニング、競争分析まで、実践的な方法をまとめています。